
O Monitor de integridade (HM, na sigla em inglês) é um agente de SDV executado em cada máquina virtual (VM) para rastrear o estado dos pacotes de serviços, determinar a integridade da VM e gerar periodicamente um relatório de integridade da VM.
Os pacotes de serviços definidos pelo OEM precisam detectar os vários indicadores de integridade informados pelo HM e, com base nos dados, realizar ações de recuperação. Por exemplo, uma instância de SDV com pacotes de serviços com falha pode precisar ser reiniciada ou atualizada.
É possível configurar o agente de HM para rastrear o seguinte:
- Status de atividade de entidades que realizam tarefas periódicas, monitorando
os sinais de funcionamento. Esse monitoramento pode ser configurado para instâncias de pacote de serviços e agentes OEM personalizados.
- Estado de recuperação das instâncias do pacote de serviços. É possível configurar pacotes de serviços para reinicialização automática em caso de falha. O HM fornece sinais para monitorar esse processo de recuperação.
- QoS de comunicação
- Atividade de agentes personalizados de SDV e OEM
Para referência, o catálogo completo da VSIDL, incluindo definições de proto, está disponível
em
//system/software_defined_vehicle/health_monitor/catalog/health_monitor.vsidl.
Terminologia
Estes termos são usados nesta página.
Trabalhar com o subsistema de HM
Para usar os recursos de HM, uma implementação de OEM precisa:
- Configure o sistema de monitoramento de integridade fornecendo arquivos de configuração, conforme detalhado em Configurar o sistema de HM.
- Use um pacote de serviços de listener de HM definido pelo OEM para detectar a saída do HM e realizar as ações adequadas.
- Desenvolva pacotes de serviços que publiquem indicadores ativamente, de acordo com a configuração de integridade. Essa publicação permite que o HM avalie o estado de integridade deles. Para mais informações, consulte os guias para desenvolvedores de pacotes de serviços.
Configurar o sistema de HM
Todas as configurações relacionadas ao HM residem em um destes tipos de configuração:
- Uma configuração global de integridade por VM
- Uma configuração de integridade por pacote de serviço, que define parâmetros de integridade para todas as instâncias do pacote
Configuração de integridade por VM
No momento da execução, o agente de HM espera uma configuração de integridade em toda a VM: um arquivo textproto (com uma extensão .textproto) do tipo VMHealth definido em //system/software_defined_vehicle/health_monitor/catalog/health_monitoring_config.proto.
A configuração de integridade da VM precisa estar localizada no caminho especificado usando a propriedade do sistema de tempo de inicialização androidboot.sdv.health_monitor.config_path.
Como alternativa, é possível configurar isso dinamicamente no ambiente de execução definindo a propriedade do sistema persist.sdv.health_monitor.config_path como um caminho personalizado. A configuração persist.* tem precedência sobre a configuração androidboot.*. É necessário
reiniciar o dispositivo para que a nova configuração entre em vigor.
A configuração de integridade da VM permite definir o seguinte:
Periodicidade do relatório de integridade da VM por meio de
period_ms. A configuração é uma compensação entre uma sinalização mais rápida de que violações de integridade foram detectadas e o desempenho do subsistema de HM. Recomendamos um valor de 100 ms.Quais agentes serão monitorados em caso de falha (consulte Monitoramento de falhas de agentes).
Exemplos de arquivos de configuração estão presentes em
//system/software_defined_vehicle/health_monitor/src/prod_configs/. Veja um exemplo de arquivo de configuração:
period_ms: 100
monitored_agent {
  agent_name: "sdv_dt_agent"
  binder_interface_name: "google.sdv.data_tunnel.IAgentService/default"
}
monitored_agent {
  agent_name: "sdv_rpc_agent"
  binder_interface_name: "google.sdv.rpc.IRpcAgent/default"
}
Neste exemplo, os agentes de DT e RPC do SDV estão configurados para monitoramento de falhas, e o relatório de integridade da VM está configurado para ser publicado a cada 100 ms.
Configuração por pacote de serviço
O monitoramento de integridade das instâncias do pacote de serviços é opcional. Para ativar, armazene o
arquivo de configuração de integridade no APEX do pacote de serviços e defina um caminho
para ele no campo health_config_path de sdv_service_bundle_metadata em
sdv_service_bundles_manifest.textproto. Para mais informações sobre manifestos de pacote de serviços, consulte Metadados do pacote de serviços.
O arquivo de configuração de integridade é um arquivo textproto do seguinte tipo:
message ServiceBundleHealthConfiguration {
  // Required: An empty ServiceBundleHealthConfiguration is equivalent to no
   // implicit health monitoring or QoS monitoring configured.
  //
  // Key should contain the instance name that the `InstanceConfiguration` applies to.
  map<string, InstanceConfiguration> instance_config = 1;
}
Para cada instância, é possível especificar a configuração de heartbeat de atividade e a configuração de QoS:
// Service bundle *instance* configuration.
message InstanceConfiguration {
  // Optional.
  //
  // Instance health monitoring configuration. Monitors instance
  // general health. Well suited for bundles executing periodic tasks.
  optional HealthConfiguration health_config = 1;

  // Optional.
   //
   // Map defining the QoS monitoring profile of the instance.
   // The key (string) is the topic name of the specific QoS heartbeat
   // publication. Choose a meaningful topic name for
   // expressive HM reporting.
   //
   // Only one publisher should publish on this topic. The HM
   // agent ignores all publishers except the first one registered
   // by the service bundle instance configured for QoS monitoring.
   map<string, QosMonitoringConfiguration> qos_config = 2;
}
Para mais informações sobre a configuração por recurso, consulte Monitoramento de heartbeats de atividade e Monitoramento de QoS.
Ouvir a saída do HM
É possível ouvir o HM por relatórios periódicos ou uma API RPC.
Relatório de integridade da VM
O monitoramento de integridade gera um relatório periódico de alta frequência sobre a integridade da VM, fornecendo informações concisas sobre o estado de integridade das entidades monitoradas.
A sintaxe de tipo de VmHealth é definida em
//system/software_defined_vehicle/health_monitor/catalog/health_topic.proto:
message VmHealth {
  // Required.
  // Describes if all monitored service bundles are healthy and report heartbeats on time.
  bool all_monitored_service_bundles_healthy = 1;

  // Required.
  // Describes if all service bundles which should be running on the VM are alive.
  bool all_service_bundles_alive = 2;

  // Required.
  // Indicates if QoS requirements for all service bundles which should be running
  // on the VM are satisfied.
  bool qos_violations_detected = 3;
}
Um pacote de serviços de listener de HM definido pelo OEM precisa detectar relatórios VMHealth
e tomar as medidas adequadas, dependendo da arquitetura completa do sistema.
As ações possíveis incluem:
- Executar rotinas de diagnóstico na VM.
- Reinicie a VM.
- Realize uma campanha de telemetria para determinar a causa.
- Atualizar o sistema ou interromper uma atualização se o sistema estiver com problemas.
API RPC do HM
O relatório de integridade da VM é uma publicação otimizada para frequência e velocidade de transmissão, fornecendo informações amplas sobre o status de integridade do sistema.
A API RPC do HM permite que o listener do HM receba informações detalhadas sobre a origem
das violações de integridade. A interface é definida em
//system/software_defined_vehicle/health_monitor/catalog/health_monitor_service.proto.
A interface é reproduzida aqui para facilitar:
// RPC Interface of the VM Health Monitor Agent for querying details about the current VM
// health.
//
// An OEM-defined service bundle typically monitors the overall health of the SDV instance by listening to
// high-frequency `VMHealth` publication. If violations are detected, this RPC interface can
// be used to retrieve detailed information about the malfunctioning component.
service HealthMonitorService {
  // Returns the list of running SDV service bundles that were created or started
  // by the orchestrator on this VM.
  rpc ListAllServiceBundles(ListAllServiceBundlesRequest) returns (ListAllServiceBundlesResponse) {}

  // Returns the list of crashed SDV service bundles.
  rpc ListCrashingServiceBundles(ListCrashingServiceBundlesRequest)
      returns (ListCrashingServiceBundlesResponse) {}

  // Returns the list of recovering SDV service bundles.
  rpc ListRecoveringServiceBundles(ListRecoveringServiceBundlesRequest)
      returns (ListRecoveringServiceBundlesResponse) {}

  // Returns the list of monitored SDV service bundles, which registered for reporting
  // aliveness heartbeats but failed to report heartbeats on time.
  rpc ListUnhealthyMonitoredServiceBundles(ListUnhealthyMonitoredServiceBundlesRequest)
      returns (ListUnhealthyMonitoredServiceBundlesResponse) {}

  // Returns a list of QoS monitoring violations detected.
  // Provides a snapshot of the current system state.
  rpc ListQosViolations(ListQosViolationsRequest)
      returns (ListQosViolationsResponse) {}
}
Descrição detalhada dos recursos
Nesta seção, descrevemos vários aspectos do HM em mais detalhes.
Monitoramento de heartbeats de atividade
Quando o monitoramento de atividade é configurado para uma instância de pacote de serviços, o HM espera que a instância publique heartbeats periódicos para provar que a lógica de negócios está funcionando corretamente. Esse monitoramento é mais adequado para instâncias de pacote de serviços que realizam tarefas periódicas. Além disso, os pacotes que usam ambientes de execução assíncronos podem usar o monitoramento de atividade para provar que o pool de linhas de execução não está esgotado.
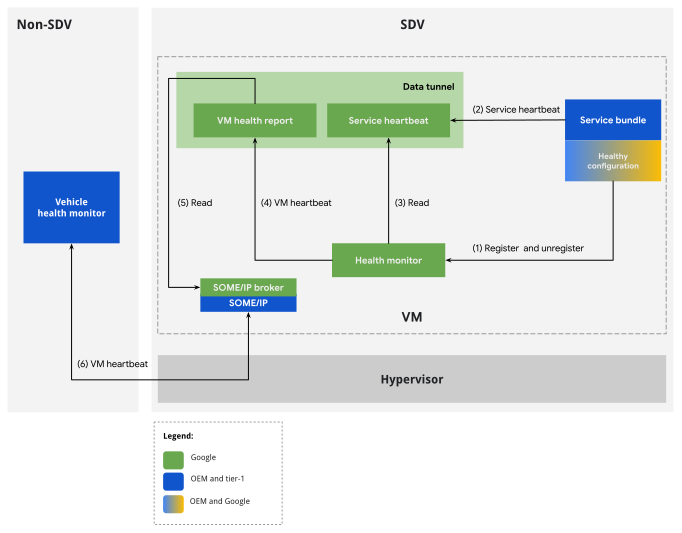
Figura 1. Fluxo de monitoramento de atividade do HM.
Configuração
Para ativar o HB de atividade em uma instância de pacote de serviços, adicione uma instância de
HealthConfiguration ao campo health_config na
configuração do pacote.
Uma configuração de heartbeat de atividade define um conjunto predeterminado de parâmetros que estabelecem os critérios para avaliar o sinal de heartbeat periódico de um serviço. Se as características do heartbeat do serviço se desviarem desses parâmetros, ele será classificado como atrasado, e o pacote de serviços correspondente como não íntegro, o que pode indicar um estado operacional não ideal.
Um pacote de serviços é considerado íntegro quando informa heartbeats no prazo,
de acordo com a configuração de integridade. No caso de uma falha ou alta carga do sistema, um heartbeat pode estar ausente ou atrasado, fazendo com que o pacote de serviços seja
marcado como não íntegro. Nesse caso, uma violação aparece no relatório VmHealth.
Os desenvolvedores de pacotes de serviços precisam definir a configuração de integridade de um pacote de serviços nos metadados do APEX correspondentes. A configuração de integridade define estes critérios:
O atraso inicial máximo permitido entre o início do serviço e a primeira detecção de heartbeat.
O período em que o pacote de serviços do SDV executa a lógica de negócios, que corresponde à periodicidade de publicação de um heartbeat de serviço.
O número de períodos que precisam ser perdidos antes que o HM considere o pacote de serviços não íntegro.
O tempo de execução é o tempo que um pacote de serviços de SDV precisa para executar a lógica de negócios antes de publicar um heartbeat de serviço.
O pacote de serviços gera uma violação de integridade se o heartbeat do serviço estiver atrasado. Há dois casos com base no momento da observação de integridade:
Caso 1: o heartbeat inicial não foi recebido. Se mais do que o atraso inicial permitido tiver decorrido entre o início do pacote de serviços e o momento da observação, o pacote de serviços será considerado não íntegro.
Caso 2: os heartbeats já foram recebidos. Se um limite tiver decorrido entre o último heartbeat e o momento da observação, o pacote de serviços será considerado não íntegro. Esse limite é calculado como a soma do período do relatório (multiplicado pelo número de períodos) e da duração da tarefa.
O formato de configuração de integridade é definido em
//system/software_defined_vehicle/health_monitor/catalog/health_config.proto:
package com.android.sdv.health;

// Service Bundle's configuration for health monitoring.
message HealthConfiguration {
  // Required.
  // Initial delay in milliseconds is the time between the service starts and its first heartbeat.
  optional uint64 initial_delay_ms = 2;

  // Required.
  // Period of reporting a heartbeat in milliseconds which corresponds to the periodicity of
  // executing a business logic by the SDV service. This value should be larger than 0.
  optional uint64 period_ms = 3;

  // Required.
  // The number of periods missing a heartbeat before the Health Monitor should consider the
  // service as unhealthy. This value should be larger than 0.
  optional uint64 num_periods = 4;

  // Required.
  // Duration of the business logic the SDV service bundle executes in milliseconds.
  optional uint64 task_duration_ms = 5;
}
Considerações sobre o tempo de execução
Esta seção fornece orientações para publicar heartbeats de atividade e se registrar corretamente para monitoramento.
Publicar sinais de funcionamento
Uma instância de pacote de serviços gera uma mensagem de heartbeat de serviço que inclui um carimbo de data/hora. Gere a mensagem de forma rotineira, normalmente logo após a execução da lógica de negócios principal. A pulsação do serviço indica que o pacote de serviços está ativo.
O objeto de instância do pacote a ser monitorado precisa criar um editor do tipo ServiceHeartbeat, que está disponível na biblioteca libhealth_api:
 message ServiceHeartbeat {
   // Required.
   // The timestamp.
   .google.protobuf.Timestamp timestamp = 1;
 }
Escolha o tópico de publicação de forma arbitrária. O agente de HM usa a descoberta por tipo de mensagem para detectar a publicação.
Ao configurar o monitoramento de atividade usando a configuração de integridade vinculada no
manifesto do pacote de serviços correspondente, o agente de HM espera que os HBs sejam
publicados assim que a instância terminar a rotina on_start. Recomendamos
manter on_start curto para evitar o bloqueio da inicialização do sistema. Portanto, publique
heartbeats em uma tarefa assíncrona iniciada em on_start.
Os desenvolvedores de pacotes podem personalizar o momento em que o primeiro heartbeat é esperado usando
a entrada de configuração initial_delay_ms.
A instância do pacote precisa continuar publicando heartbeats até ser interrompida. Uma
instância é considerada interrompida quando a rotina on_stop é concluída.
Caso de uso especial: registrar explicitamente para o monitoramento de heartbeat
O comportamento descrito em Monitoramento de heartbeats de atividade, em que os heartbeats
são esperados entre on_start e on_stop, é chamado de monitoramento de atividade
implícito. Essa é a maneira recomendada de usar o recurso: ela simplifica a
lógica de negócios do pacote e garante que ele seja sempre monitorado.
No entanto, podem existir alguns casos de uso em que o período de monitoramento padrão é uma restrição:
- Uma instância de pacote de serviços contém lógica de negócios periódica em um intervalo de tempo não vinculado aos eventos
startestop. O monitoramento de atividade pode ser necessário apenas nesse período personalizado. - O HM rastreia com precisão os HBs em períodos de suspensão e retomada. Portanto,
o pacote pode querer continuar sendo monitorado após
on_stop. - Os agentes OEM personalizados podem não ser implementados como pacotes de serviços. Portanto, eles não podem se beneficiar do monitoramento de atividade implícito. No entanto, eles ainda podem exigir monitoramento de atividade.
Nesses casos, o HM permite que você ignore o registro implícito no monitoramento de atividade
e use o registro explícito. Para usar o registro explícito, uma
instância de pacote precisa desativar o registro implícito. Para isso, não inclua uma
entrada do tipo HealthConfiguration para a instância específica no manifesto do
pacote. Em seguida, no momento da execução, a instância do pacote precisa usar a API RPC definida
em
//system/software_defined_vehicle/health_monitor/catalog/health_monitor_registration_service.proto
para se registrar e cancelar o registro manualmente no monitoramento. As pulsações publicadas são
esperadas assim que a chamada RPC de registro for bem-sucedida.
Para conferir um exemplo de implementação, consulte
//system/software_defined_vehicle/samples/health/stable/health_monitored_service_bundle/.
Monitoramento de QoS
A Qualidade de Serviço (QoS, na sigla em inglês) é uma medida de comunicação. O HM monitora se a mensagem enviada passa muito tempo em trânsito ou, no caso de comunicação periódica, se as mensagens não são recebidas com a frequência escolhida.
O SDV oferece vários tipos de comunicação Pub/Sub e RPC. O denominador comum é que todos os esquemas de comunicação contêm pelo menos um listener. Para que o HM monitore a comunicação, essa instância do pacote de serviços de detecção precisa publicar heartbeats de QoS especiais sempre que receber uma mensagem de interesse.
Configuração
Para ativar o monitoramento de QoS de uma comunicação, primeiro identifique o listener de comunicação que vai publicar o heartbeat de QoS. Em seguida, para a instância do pacote de serviços
identificada, adicione um ou mais mapeamentos de tópico para QosMonitoringConfiguration
no campo qos_config. Para mais informações, consulte
Configuração de pacote por serviço.
O tópico é uma string que define o tópico de publicação em que o HM espera HBs de QoS no momento da execução. Uma instância de pacote de detecção pode participar de várias comunicações e informar HBs de QoS em vários tópicos.
Os tópicos precisam ser descritivos, já que são informados ao pacote de serviços do listener de HM se violações de QoS forem detectadas no momento da execução.
O tipo QosMonitoringConfiguration é definido em
//system/software_defined_vehicle/health_monitor/catalog/health_config.proto:
message QosMonitoringConfiguration {
  // Optional - If absent, heartbeat frequency monitoring is disabled for this SB.
  //
  // The maximum allowable interval between consecutive heartbeats (in milliseconds).
  // A QoS frequency violation is triggered if the time elapsed between
  // two heartbeats exceeds this threshold.
  optional uint64 qos_period_threshold_ms = 1;

  // Optional - If absent, heartbeat latency monitoring is disabled for this SB.
  //
  // The maximum allowable interval between data publication and data processing timestamps (in milliseconds).
  // A QoS latency violation is triggered if the time elapsed between
  // data publication and data processing timestamps exceeds this threshold.
  optional uint64 qos_latency_threshold_ms = 2;
}
Para casos de uso padrão, aplique os dois tipos de monitoramento de QoS. Um
qos_latency_threshold_ms de 30 é razoável para a comunicação do Pub/Sub na VM
em cargas normais do sistema.
Considerações sobre o tempo de execução
Assim como o monitoramento de HB de atividade, o pacote de detecção de comunicação precisa publicar um tipo de heartbeat. Nesse caso, um HB de QoS precisa ser publicado sempre que mensagens de interesse forem recebidas, em vez de no final da execução da lógica de negócios.
Um HB de QoS é do tipo QosHeartbeat, definido em
//system/software_defined_vehicle/health_monitor/catalog/qos_heartbeat.proto:
message QosHeartbeat {
  option (.sdv.vsidl.v1.publication) = {
    message_count: 2
    model: SINGLE_PUB
  };
  // Required.
  // Current timestamp at heartbeat transmission. The heartbeat should be sent
  // immediately after the listener receives the related QoS-monitored message.
  .google.protobuf.Timestamp timestamp = 1;

  // Required.
  // Timestamp corresponding to the creation time of the underlying data. This
  // implies that, in addition to the data of interest, the monitored message includes
  // a data creation timestamp field. The listener is responsible for routing this
  // timestamp to the QosHeartbeat upon receiving a QoS-monitored message.
  .google.protobuf.Timestamp data_timestamp = 2;
}
O momento de registrar e cancelar o registro da publicação de HB de QoS é fundamental para um monitoramento preciso. O HM espera HBs de QoS entre esses dois eventos. O pacote de detecção de mensagens precisa registrar a publicação do QoS HB quando a comunicação monitorada é registrada com a pilha de comunicação do SDV. O HM pode usar a API de disponibilidade para fazer isso. Para mais informações, consulte Determinar a disponibilidade do serviço.
Monitoramento de recuperação de pacotes de serviços
A recuperação de instâncias de pacote de serviço é configurada como parte dos arquivos de configuração do agente de orquestração. Para uma abordagem completa do tópico, consulte Pacotes de serviços. O subsistema de HM observa passivamente o processo de recuperação. Quando
uma falha na recuperação de uma instância de pacote é detectada, uma violação é adicionada ao
relatório do VMHealth. Ao contrário do restante dos recursos de monitoramento do HM,
o monitoramento de recuperação é obrigatório e não configurável.
Falhas de instâncias de pacote de serviços que não estão configuradas para recuperação geram uma violação de integridade na primeira falha.
A recuperação de instâncias do pacote de serviços foi projetada para se integrar ao monitoramento de atividade de heartbeat. O sistema de HM é mais tolerante ao avaliar as pulsações quando detecta que o pacote está se recuperando. Na prática, essa tolerância significa que os pacotes de serviços não precisam realizar outras etapas de cancelamento ou registro de monitoramento se falharem.
Monitoramento de falhas do agente
O HM detecta possíveis falhas de agentes de SDV usando o mecanismo de binder
linkToDeath.
É possível configurar o monitoramento de falhas como parte da configuração de integridade da VM (consulte
Configuração por instância de SDV (VM)), especificamente o campo repetido
monitored_agent. Esse campo precisa conter entradas do tipo BinderServiceAgent:
message BinderServiceAgent {
  // agent_names must be unique across configuration
  // used for HM internal agent identification, and naming entries in HM dumpsys report
  string agent_name = 1;

  // Binder interface name/identifier, e.g: "google.sdv.data_tunnel.IAgentService/default"
  // HM Agent should have appropriate permissions to find the binder interface
  // see also `sdv_crash_monitored_service` selinux attribute
  string binder_interface_name = 2;
}
Os agentes personalizados também podem ser monitorados se expuserem uma interface de binder. Para monitorar um agente personalizado, conceda as permissões do SELinux do HM para detectar a interface de binder adequada.
A propriedade do sistema ro.boot.sdv.health_monitor.agent_startup_timeout_sec pode
substituir o tempo que o HM espera para que os agentes registrem as interfaces de binder
depois que o HM é iniciado. A menos que seja exigido por agentes personalizados, o padrão de três
segundos é apropriado.
Guias de desenvolvimento de pacotes de serviços
Esta seção fornece guias explicativos sobre como usar os recursos de HM de pacotes de serviços, em contraste com o tratamento teórico nas seções anteriores. A
amostra de referência atualizada, em que esses guias se baseiam, é a
qos_monitoring. Siga o
//system/software_defined_vehicle/samples/health/stable/qos_monitoring/README
do exemplo para ter uma experiência prática.
Adicionar o monitoramento de heartbeat de atividade a um pacote de serviços
Esse método é a maneira mais direta de ativar o monitoramento de integridade para um pacote de serviços:
Defina uma instância de
ServiceBundleHealthConfigurationpara as instâncias do pacote em um arquivo chamadohealth_configuration.textproto:# health_bundle_configuration.textproto instance_config { key: "instance1" value: { health_config { initial_delay_ms: 1000 period_ms: 500 num_periods: 2 task_duration_ms: 200 } # qos_config entries irrelevant for this dev guide qos_config { ... } } }Adicione o arquivo de configuração ao APEX do pacote de serviços. Em um
Android.bp:apex { name: "com.android.sdv.sample.oem.health.qos_monitoring", // ... prebuilts: [ // ... "com.android.sdv.sample.oem.health.qos_monitoring.health_config", ], } prebuilt_etc { name: "com.android.sdv.sample.oem.health.qos_monitoring.health_config", src: "health_configuration.textproto", filename: "health.textproto", // ... // Reduce prebuilt visibility to avoid adding it in another APEX. visibility: ["//system/software_defined_vehicle/samples/health/qos_monitoring/apex"], }Armazene a configuração de integridade no APEX e defina o
health_config_pathno manifesto:# sdv_service_bundles_manifest.textproto sdv_service_bundle_metadata { ... health_config_path: "etc/config/health_configuration.textproto" }Na definição do VSIDL, verifique se o pacote publica
com.android.sdv.health.ServiceHeartbeat:sdv_service_bundle { name: "SampleBundle" publisher { message: "com.android.sdv.health.ServiceHeartbeat" topic: "arbitrary-topic" capacity: 2 } }Adicione permissões de SDV ao pacote para que ele seja autorizado a publicar HBs:
  publisher {
    type: "com.android.sdv.health.ServiceHeartbeat"
  }
Publique periodicamente os heartbeats do serviço no código, começando em
on_start:// ... fn on_start(&mut self) { // ... runtime.spawn(business_logic(self.context)) } async fn business_logic(context: ContextRef) -> SdvResult<()>{ // register HB publication let mw_comms = SdvComms { context }; let aliveness_hb_pub = create_publisher::<PublisherDescriptor<ServiceHeartbeat>>( &mw_comms, PublisherDescriptors::<ServiceHeartbeat>::ARBITRARY_TOPIC, ) .await?; loop{ // do business logic // ... // publish hb aliveness_hb_pub.publish(&ServiceHeartbeat { timestamp: MessageField(Some(Box::new(now.into()))), ..Default::default() })?; } }
Caso de uso especial: registro explícito
Para casos de uso mais especiais, em que o pacote precisa de monitoramento de HB para ciclos de vida
personalizados (por exemplo, monitoramento que começa antes ou termina depois do
estado STARTED padrão), use o método de registro explícito:
Na definição do VSIDL, adicione um cliente
com.android.sdv.health.HealthMonitorRegistrationService:sdv_service_bundle { # ... client { service: "com.android.sdv.health.HealthMonitorRegistrationService" channel: "com-android-sdv-health-health-monitor-registration-service" } }Adicione a permissão de SDV para usar o RPC de registro de HB de atividade:
  # ...
  client {
    service: "com.android.sdv.health.HealthMonitorRegistrationService"
    channel: "com-android-sdv-health-health-monitor-registration-service"
  }
Registre-se no HM por RPC, por exemplo, em
on_startounew:let rpc_client = Self::new_client(comms).await?; let _ = rpc_client .RegisterConfiguration(&RegisterConfigurationRequest { config: Some(HealthConfiguration{ initial_delay_ms: 100, period_ms: 200, num_periods: 3, task_duration_ms: 40, special_fields: protobuf::SpecialFields::default(), }).into(), ..Default::default() }) .await .unwrap();Publicar HBs.
Cancele o registro do monitoramento quando ele não for mais necessário:
let _ = rpc_client
  .UnregisterConfiguration(&UnregisterConfigurationRequest { ..Default::default() })
  .await
  .unwrap();
Adicionar o monitoramento de QoS à comunicação
Verifique se a instância do pacote de serviços é assinante de um tópico chamado
fog-light-statusno catálogo do VSIDL:subscriber { message: "QosMonitoredFogLightStatus" topic: "left-fog-light-status" }O formato da mensagem é o seguinte:
package com.android.sdv.sample.oem.health.qos_monitoring; import "google/protobuf/timestamp.proto"; message QosMonitoredFogLightStatus { // arbitrary fields related to business logic int32 status = 1; // A QoS-monitored message must include a timestamp field .google.protobuf.Timestamp timestamp = 2; }Defina uma instância de
ServiceBundleHealthConfigurationpara as instâncias de pacote em um arquivohealth_configuration.textprotoque inclua o monitoramento de QoS:# health_bundle_configuration.textproto instance_config { key: "instance1" value: { # aliveness HB monitoring config irrelevant for this dev guide health_config { ... } qos_config { key: "qos-hb-right-fog-light-status" value { qos_period_threshold_ms: 100 qos_latency_threshold_ms: 50 } } } }O tópico escolhido no campo
keyilustra que os HBs de QoS serão publicados nesse tópico, permitindo o monitoramento de um tópico chamadofog-light-status.Adicione o arquivo de configuração ao APEX do pacote de serviços. Em um
Android.bp:apex { name: "com.android.sdv.sample.oem.health.qos_monitoring", // ... prebuilts: [ // ... "com.android.sdv.sample.oem.health.qos_monitoring.health_config", ], } prebuilt_etc { name: "com.android.sdv.sample.oem.health.qos_monitoring.health_config", src: "health_configuration.textproto", filename: "health.textproto", // ... // Reduce prebuilt visibility to avoid adding it in another APEX. visibility: ["//system/software_defined_vehicle/samples/health/qos_monitoring/apex"], }Armazene a configuração de integridade no APEX e defina
health_config_pathno manifesto:# sdv_service_bundles_manifest.textproto sdv_service_bundle_metadata { ... health_config_path: "etc/config/health_configuration.textproto" }Na definição do VSIDL, verifique se o pacote é um editor de
com.android.sdv.health.QosHeartbeat:sdv_service_bundle { name: "SampleBundle" publisher { message: "com.android.sdv.health.QosHeartbeat" topic: "qos-hb-right-fog-light-status" capacity: 2 } }Adicione permissões de SDV ao pacote para que ele seja autorizado a publicar HBs de QoS:
publisher { message: "com.android.sdv.health.QosHeartbeat" topic: "qos-hb-right-fog-light-status" }Registre a publicação de QoS HB somente quando a comunicação monitorada estiver registrada. Use a API de disponibilidade de
libsdv_mw_clientlib:// Wait for monitored communication to be available let comms = SdvComms{context}; let registration_stream = create_registration_event_stream( &comms, SubscriberDescriptors::<QosMonitoredFogLightStatus>::LEFT_FOG_LIGHT_STATUS, ).await?; let mut registration_stream = Box::pin(registration_stream.filter(|e|e==Availability::Available)); registration_stream.next().await; // only when available, create QoS HB publication: let qos_hb_pub = create_publisher( &comms, PublisherDescriptors::<QosHeartbeat>::QOS_HB_LEFT_FOG_LIGHT_STATUS, ).await?; // ...Publique HBs de QoS sempre que uma mensagem for recebida:
// ... use tap::Pipe; fn flatten_mw<T: Send>( s: impl Stream<Item = SdvResult<Vec<T>>> + Send + Unpin, ) -> impl Stream<Item = SdvResult<T>> + Send + Unpin { s.flat_map(|v| match v { Ok(v) => v.into_iter().map(Ok).pipe(stream::iter).left_stream(), Err(err) => Err(err).pipe(future::ready).pipe(stream::once).right_stream(), }) } { // ... let data_stream = create_observer( &comms, SubscriberDescriptors::<QosMonitoredFogLightStatus>::LEFT_FOG_LIGHT_STATUS, SubscribeOptions::default() ) .pipe(flatten_mw) .await?; while let Some(data) = data_stream.next().await { // publish QoS HB. Note how data.timestamp is used to populate the field qos_hb_pub.publish( &QosHeartbeat { timestamp: SystemTime::now(), data_timestamp: data.timestamp, ..Default::default() } ) // use data // ... } }Para interromper o monitoramento de QoS, remova o objeto do editor:
// ...
drop(qos_hb_pub);
Depurar o monitoramento de integridade
Para fins de depuração e visão geral do sistema, use a ferramenta dumpsys para monitorar o estado de monitoramento de integridade da VM:
adb shell dumpsys com.google.sdv.ISdvAgent/hm
O relatório detalha a configuração de relatórios de integridade da VM, a configuração do pacote e o estado de monitoramento. Veja um exemplo desse relatório:
AGENT NAME: SDV Agent dump - Health Monitor
AGENT FQIN: instance1:com.android.sdv.health.HealthMonitorServiceBundle/instance1
AGENT STATE: Started
----------------
----------------
INTERNAL STATE REPORTERS:

*NAME: VM health report period:
*REPORT:
100----------------
*NAME: Recovery monitor manager
*REPORT:

HEARTBEAT MONITORING:
NO ACTIVE MONITORS

QOS MONITORING:
NO ACTIVE MONITORS
RECOVERY MONITORING:
a. Agent monitoring:
MONITOR 0:
ID: Agent: sdv_vsidl_provider_agent
linked_binder: com.google.sdv.ISdvAgent/vsidl_provider
alive: true

MONITOR 1:
ID: Agent: sdv_someip_broker
linked_binder: com.google.sdv.ISdvAgent/someip_broker
alive: false

b. SB monitoring:
MONITOR 0:
ID: FQIN: instance1:com.android.sdv.test.orchestrator.OrchSampleInitialPowerState/sample-initial-power-state
Recovery State: Normal
Lifecycle State: Started
Health Status: Healthy
MONITOR 1:
ID: FQIN: instance1:com.android.sdv.sample.apex.provider.Provider/sample-provider-v1
Recovery State: Normal
Lifecycle State: Started
Health Status: Healthy
MONITOR 2:
ID: FQIN: instance1:com.sdv.google.display_safety.HarSdvVehicleDataPublisher/instance-1
Recovery State: Normal
Lifecycle State: Started
Health Status: Healthy
----------------
*NAME: Health monitor
*REPORT:
CURR TIMESTAMP(ns): 1775543863756836167
INTERNAL STATE:
background_thread running: true
should_run: true

----------------